



Про LLMS.txt пишут по-разному. В одних статьях его подают как способ гарантированно попасть в ответы нейросетей, в других – как пункт, без которого техническая оптимизация неполна. Оба тезиса завышены, а из-за разноголосицы владельцу сайта трудно понять, стоит ли вообще возиться с файлом.
По сути LLMS.txt – это текстовый файл в формате Markdown, который сообщество предложило как удобную визитку сайта: короткое описание плюс подборка ссылок на главные страницы. Доступом роботов он не распоряжается и не подменяет привычные robots.txt, sitemap.xml или разметку Schema.org. Обязательным стандартом формат пока не признан. Google отдельно поясняет: чтобы попасть в его AI-функции, никаких особых файлов заводить не требуется.
Ниже разложим тему по полочкам: зачем придумали файл, где проходит граница между ним и robots.txt или sitemap.xml, читают ли его системы прямо сейчас, что внутри по спецификации и как собрать его самостоятельно. Проверенные факты сразу отделим от догадок – чтобы вы не вкладывались в то, что пока работает без гарантий.
Что такое LLMS.txt и для чего предложен этот файл
Предложение появилось в 2024 году и выросло из практической проблемы языковых моделей: окно контекста у них ограничено, а продираться через тяжелый HTML с меню, скриптами и рекламой – расход этого окна впустую. Файл LLMS.txt решает задачу иначе: подает модели готовую сводку – о чем сайт и где искать ключевые материалы.
Хранят его в корне сайта и оформляют в Markdown. Структура простая: имя проекта, пара строк о нем и сгруппированные ссылки с короткими подписями. Задумка авторов в том, чтобы модель тратила меньше усилий на поиск нужного и точнее трактовала содержимое.
Почему LLMS.txt не является аналогом robots.txt
Задача robots.txt – регулировать обход: он указывает краулерам, куда можно заходить, а куда нет. У LLMS.txt полномочий нет вовсе: он ничего не открывает и не закрывает – только намекает, какие материалы считать главными.
Отсюда важное следствие: от обучения моделей и от индексации LLMS.txt контент не ограждает. Если нужно реально закрыть доступ, работают прежние инструменты – robots.txt и настройки на стороне сервера.
Чем LLMS.txt отличается от sitemap.xml и структурированных данных
Sitemap.xml перечисляет все адреса сайта в машинном виде и адресован поисковым краулерам. LLMS.txt устроен противоположно: в него попадает только отобранная выжимка страниц, снабженная понятными человеку подписями и без служебной разметки.
Разметка Schema.org описывает отдельные сущности на конкретной странице машинным языком – товар, статью, организацию. LLMS.txt смотрит шире, на весь ресурс, и дает обзорную карту вместо детального описания одного объекта. Поэтому инструменты не соперничают: у каждого своя задача.
Поддерживают ли поисковые системы и нейросети LLMS.txt сегодня
Для бизнеса важен один прикладной вопрос: обращается ли к файлу хоть кто-то на практике. На 2026 год общей и официально заявленной поддержки у формата нет.
Статус открытого предложения и отсутствие гарантий использования
Пока это инициатива сообщества, которую поисковые системы не возвели в ранг стандарта. Публично ни один крупный поисковик не заявлял, что учитывает файл при ранжировании.
Отдельные сервисы – например, платформы документации – формат действительно читают, но это точечные внедрения конкретных продуктов. Обязанности обрабатывать LLMS.txt у нейросетей и поисковиков нигде не закреплено.
Почему наличие файла не гарантирует цитирование или рост позиций
Допустим, модель файл прочитала. Решение все равно складывается из десятков сигналов: насколько полезен материал, доверяют ли источнику, отвечает ли страница на запрос. Строчка в LLMS.txt эти веса не переигрывает. Так что лозунги в духе загрузите файл – и окажетесь в ответах нейросети лучше делить надвое. Навигацию файл упростить способен, но роль качественного и достоверного контента на себя не берет.
Нужен ли LLMS.txt для SEO и попадания в нейропоиск
Если совсем коротко: классическому SEO файл не нужен; для нейропоиска его польза ограничена и в список обязательных требований он не входит.
Что официально требуется Google для AI Overviews
В своей документации по AI Overviews Google сообщает: ни особая настройка, ни отдельные файлы под ИИ-функции не требуются. В основе тот же индекс и те же правила, что и у классического поиска.
Выходит, на первом месте база: сайт должен нормально сканироваться и попадать в индекс, а его материалы – закрывать запрос. Появление LLMS.txt ни одно из этих условий не снимает.
Когда файл может быть полезен как карта контента
Ощутимый смысл файл обретает на крупных ресурсах с ветвистой структурой – порталах документации, базах знаний, объемных каталогах услуг. В таких случаях LLMS.txt для сайта работает как опрятная карта ключевых материалов. Он бережет время и читателям, и тем сервисам, что умеют его обрабатывать. А вот сайту из пары-тройки разделов заметной пользы не принесет.
Когда внедрение не должно быть приоритетом
Когда сайт спотыкается об индексацию, медленно грузится, плодит дубли или страдает от пустых страниц, силы логичнее бросить именно на это. На видимость перечисленное влияет куда сильнее, чем новый файл в корне.
Разумный момент для LLMS.txt наступает, когда техническая база и качество контента уже в порядке. В роли необязательного эксперимента он уместен; ставить его первым пунктом плана смысла мало.
Структура LLMS.txt по предложенной спецификации
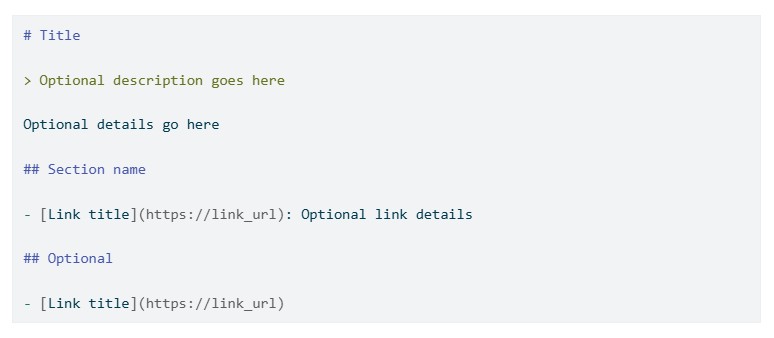
Спецификация описывает несложный и легко читаемый формат на Markdown. В основе – обязательная шапка и разбитые по разделам перечни ссылок.
Название сайта и краткое описание
Открывает файл заголовок первого уровня – это имя сайта или бренда. Сразу за ним размещают сжатое описание в формате цитаты: чем занят проект и на кого рассчитан. Формулировки в описании держат четкими, без маркетингового налета. Цель здесь – передать точный контекст, а продажа задачей не стоит.
Основные разделы и ссылки с пояснениями
Далее следуют блоки с заголовками второго уровня, под которыми выстроены ссылки. Возле каждой ставят короткую подпись – что именно откроется по ней. В главный раздел выносят приоритетные страницы – услуги, опорные руководства, справочные материалы. Подписи дают понять суть, не открывая саму ссылку.
Опциональные разделы и ссылки на Markdown-версии
Спецификация разрешает завести дополнительный блок под второстепенное – то, что модель вправе пропустить, если контекста не хватает. Еще один совет из нее – прикладывать ссылки на очищенные Markdown-версии страниц.
Разберем компактный рабочий образец для сайта услуг и поясним каждую секцию.
|
# Студия «Ориентир»
> Разработка, поддержка и продвижение сайтов для малого бизнеса.
## Основные разделы — [Услуги](https://orientir.ru/services): что делаем и на каких условиях. — [Кейсы](https://orientir.ru/cases): проекты с измеримым результатом. — [Контакты](https://orientir.ru/contacts): как связаться и где мы находимся.
## Опционально — [Блог](https://orientir.ru/blog): разборы по SEO и веб-разработке. |
Верхний заголовок задает имя, цитата под ним – описание. В блок «Основные разделы» собраны опорные страницы, в «Опционально» уходит все второстепенное.
Как создать LLMS.txt: пошаговая инструкция
Навыков программирования файл не потребует. Покажем, как создать LLMS.txt, в четыре простых шага.
Выбрать канонические и наиболее полезные страницы
Составьте перечень страниц, которые точнее всего закрывают запросы посетителей: услуги, опорные статьи, справочные разделы. Адреса берите канонические – без меток, параметров и дублей.
Копировать в файл весь сайт не нужно. Смысл сводки как раз в краткости: внутри остается только существенное.
Составить краткие однозначные описания
Для каждой ссылки добавьте однострочную подпись: что за страница и кому пригодится. Общих фраз и рекламных оборотов лучше избегать.
Чем однозначнее подпись, тем ниже шанс, что читающий файл инструмент поймет содержимое превратно.
Разместить файл в корне сайта и проверить HTTP-ответ
Сохраните документ под именем llms.txt и положите в корень, чтобы он открывался по прямой ссылке. Убедитесь, что сервер возвращает статус 200 и отдает его как текст.
Проследите, чтобы к файлу не было редиректов и его не блокировали серверные правила. А ссылки внутри пусть ведут на живые, рабочие страницы.
Настроить регулярное обновление
Сайт меняется, и файл приходится поддерживать в свежем виде. Правьте его, когда перестраиваете структуру, заводите важные разделы или убираете страницы.
На больших проектах удобно пересобирать файл автоматически вместе с картой сайта. Небольшому ресурсу хватит ручной сверки раз в квартал.
Пример LLMS.txt для сайта услуг
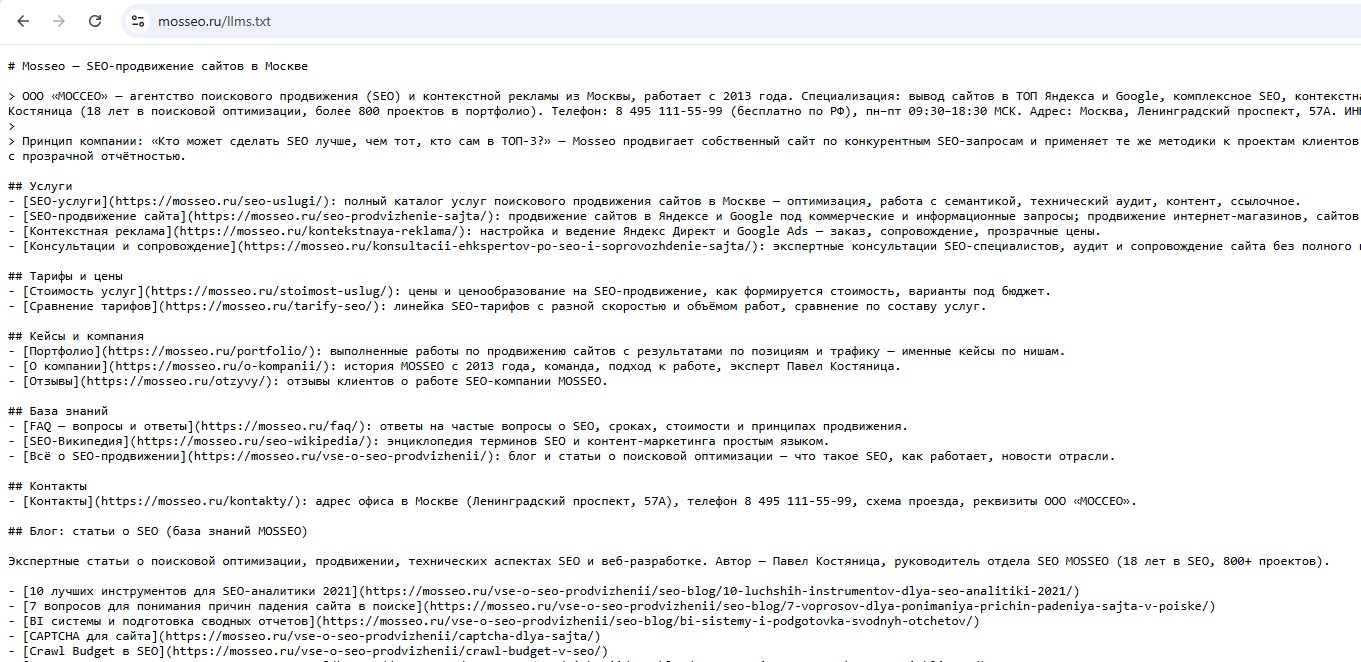
У сервисной компании готовый файл получается коротким: имя, описание и два-три блока с выверенными ссылками. Такой размер комфортно воспринимают и люди, и обрабатывающие его сервисы.
За основу берите образец выше и подгоняйте разделы под собственную структуру. Когда услуг много, разбейте их по направлениям, вместо того чтобы сваливать в один длинный список.
Обычно в файл сервисного сайта попадают страница по каждому направлению, блок с ценами или условиями, кейсы и контакты. Статьи из блога уводят в опциональную часть, чтобы главный перечень не разбухал и оставался точным. При таком раскладе сервисам проще уловить, что продает компания и куда направить посетителя.
Типовые ошибки при создании LLMS.txt
Промахи кочуют от проекта к проекту и выглядят похоже:
- вместо короткой выборки в файл сваливают весь сайт целиком;
- подписи повторяют заголовки и ничего не добавляют по сути;
- ссылки упираются в дубли, адреса с параметрами или редиректы;
- файл собирают однажды и больше к нему не возвращаются;
- от него ждут гарантированного роста позиций и места в ответах.
Особняком стоит еще один промах – закрывать этим файлом фундаментальные вещи: индексацию, скорость загрузки и качество текстов.
Что важнее LLMS.txt для SEO и AI-видимости
На видимость в поиске и у нейросетей сильнее влияют давно проверенные вещи. Чистая индексация, прозрачная структура, экспертные тексты и доверие к источнику сдвигают результат ощутимее любого нового файла.
Разметка Schema.org, аккуратный sitemap.xml и грамотная перелинковка приносят предсказуемую отдачу прямо сегодня. LLMS.txt логично воспринимать как надстройку над этой базой, а подменять ее им не стоит.
Как проверить техническую готовность сайта к нейропоиску
Прежде чем экспериментировать с новыми файлами, стоит проверить фундамент. Минимальный аудит охватывает:
- открытость и попадание в индекс главных страниц;
- отрисовку контента без обязательного действия пользователя;
- корректные canonical, sitemap.xml и robots.txt;
- разметку структурированных данных под тип страницы;
- скорость загрузки и устойчивость ответа сервера.
Как только эти пункты закрыты, сайт уже пригоден для обработки и поисковыми, и генеративными системами. LLMS.txt тогда кладут сверху – как опрятную карту, отводя ему роль вспомогательную, не основную.
Выводы
LLMS.txt – это предложенный формат без статуса обязательного стандарта ранжирования. Он рисует краткую карту сайта для сервисов, которые умеют его читать, но доступом роботов не управляет и цитирование в нейросетях не обещает.
И для SEO, и для нейропоиска первым делом закрывают фундамент: индексацию, скорость, структуру, экспертные тексты и разметку данных. Уже поверх этого LLMS.txt уместен как необязательное дополнение – прежде всего на объемных сайтах со сложной структурой.
Решили внедрять – отберите канонические страницы, снабдите их однозначными подписями, положите файл в корень и держите его в актуальном виде. Тогда LLMS.txt для сайта поможет навигации и не породит ложных ожиданий.